手册 · 章节 10
文字、标题与字幕
标题及其样式和动画、词语强调、从语音或文件生成字幕、字幕样式,以及 AI 朗读字幕。
标题
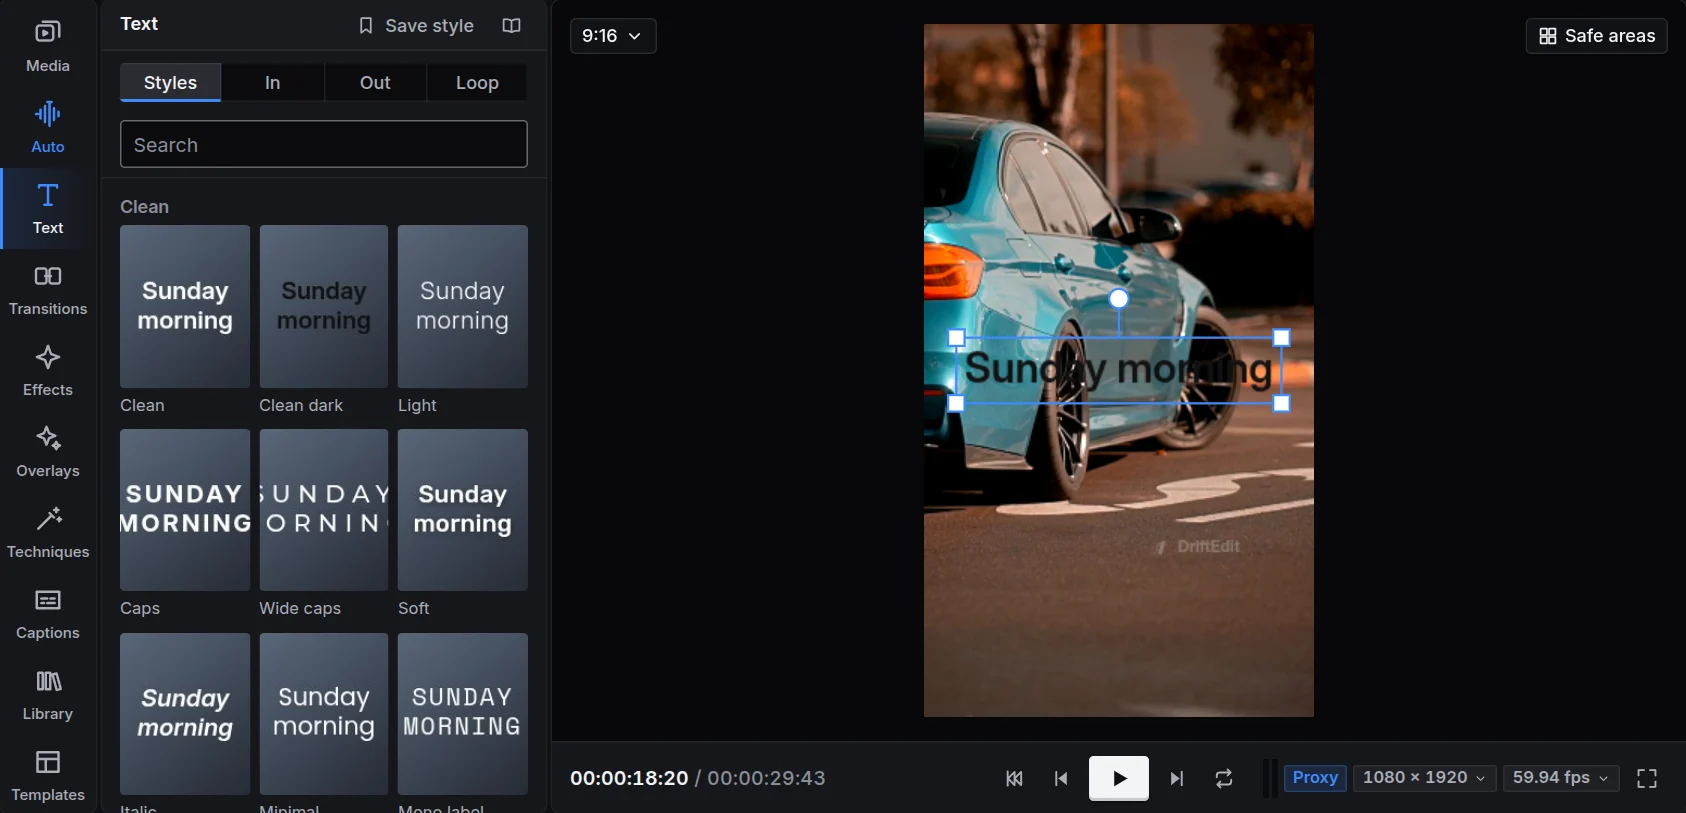
打开左侧文字。每张卡片都是一种文字样式:字体、颜色、描边或底框、阴影或辉光。
- 未选中标题时,点击样式可在播放头处创建该样式的标题,也可将样式拖到时间线上的目标位置。
- 选中标题后点击样式,可更换样式。
- 在检查器的视频标签下的文字中输入内容,或双击预览器中的标题直接输入。Escape 结束输入。
- 像画面一样在预览器中移动、缩放和旋转标题。安全区显示手机应用按钮会遮住的位置。
外观
检查器的视频标签下,文字提供外观的每个部分:字体和字号、颜色、描边、阴影与辉光、文字底框、间距和对齐。选中多个标题可一起修改。喜欢的外观可保存为自己的样式,位于我的下。
动画
在入场、出场和循环下,选择标题如何出现、离开,以及在屏幕上如何运动:逐字母、逐词或逐行,以打字、弹跳、淡入淡出、滑动、弹出等多种方式呈现。各动画时长在检查器中设置。
强调
在检查器中选取标题的一个词,为它单独设置颜色、粗体、较大字号、下划线或荧光笔色带,可静止显示,也可在说到该词时绘出。编辑文字时,强调会跟随该词保留。
字幕
打开左侧字幕。字幕位于独立轨道,统一设置样式。
生成字幕
- 语音转字幕:DriftEdit 在你的设备上聆听片段声音,将话语转成文字,并为每个词标定时间,支持 99 种语言。语音模型(80 MB)在首次使用时下载。剪辑时,每条字幕都会跟着其镜头移动。 高亮正在说的词 默认打开,会在每个词说出时为它上色;朗读和录制生成的字幕也使用同一设置。 说话人 默认开启,会找出说话的人,并在每次轮换时命名为说话人1、说话人2(首次另需 8 MB);两人同时说话时共用一条字幕,各占一行。声音 会用字幕的语言为没有人说话处听到的内容加字幕,如音乐、掌声、笑声、门声(另需 15 MB)。语音转字幕也在音频轨道的菜单中(针对轨道上的所有片段),以及片段的菜单中(针对所选片段)。重新生成时会重新聆听声音。窗口会记住你的选择(包括语言),供下次使用。听写的内容会边听边保存:如果听写中途停止(显卡掉线、窗口被关闭),再次生成字幕会从那里继续。当两段声音同时播放且都有语音时(例如屏幕录制和旁边录下的人声),同一时刻说的话会合并为一条字幕,每人一行;开启说话人时会带上名字。
- 导入 SRT 或 WebVTT,或将字幕文件拖到工作室任意位置。
- 添加字幕在播放头处输入一条字幕。
编辑字幕
在行数下可以看到每条字幕及其时间:点击时间可跳到该处,输入可修改文字。在时间线上,字幕也是片段:拖动可移动,拖动边缘可修改显示时长。
谁在说话,以及声音
把一行写成 姓名: 加上所说的话,名字就会以此人的颜色显示。字幕文件里的说话人(WebVTT 的声音,或冒号前的大写名字)会自动导入。在 说话人 中,每个人都有颜色和名字:改名后,此人的每一行都会随之更改。添加 可新建一位,并在每条字幕旁选择谁说第一行。两人同时说话时,他们的台词会在同一条字幕中上下并列显示。方括号中的声音,如 [掌声],显示为斜体,♪ 表示音乐。文件放在顶部的字幕会留在顶部,导出 SRT 和 WebVTT 时也会保留说话人和位置。朗读 不会读出名字、声音或音乐:在 每个人的声音 中,每个人都有自己的声音和语气,只有声音的字幕保持静音,留在原位。
说话人显示 决定名字在每条字幕中如何出现:显示名字 在话语前显示名字;用其颜色 不显示名字,话语用此人的颜色;不显示 只显示话语。无论选哪种,说话人都会保留:随时可以改,导出的 SRT 和 WebVTT 也仍然写明每位说话人。
字幕样式
在样式下选择字幕样式。所选样式会保存在你的账户中:在还没有字幕的项目里新建的字幕会使用该样式。多数样式会像卡拉 OK 一样标出正在说的词。位置可设为顶部、中部或底部。烧录到视频中将字幕画入导出视频;关闭后,字幕保留为独立文件,可导出为 SRT 或 WebVTT。一次一个字词只在中间显示正在说的那个词。
朗读字幕
朗读为字幕配上 AI 声音:女声或男声,覆盖工作室全部十三种语言。每条字幕都会朗读,每个词与声音对齐,配音放在独立轨道,所以标记当前词的字幕样式也会跟着声音走。配音模型在首次使用时下载,同时下载为词语定时的语音模型(80 MB,显卡上为 113 MB)。也可以在字幕轨道菜单、单条字幕菜单或序列菜单中选择朗读字幕。
选中字幕或标题时,窗口会从已选开始:只朗读这些,其他字幕保持原样;全部字幕会全部朗读。每一行都保持声音本来的语速;打开 让每一行适配片段 后,会改为以填满其片段的语速说出,片段短则更快,片段长则稍慢。 标题位置不变,时长至少与它的声音一样长:在检查器中选择文字下方的朗读,或在标题菜单中选择朗读文字(AI 语音)。语气决定听起来的感觉:自然、平静、兴奋、喊叫、严肃或悲伤。语音模型没有自己的情绪,所以每种语气会选用模型的一种声音,以及它的语速、音高和音色。声音会放在有空位的 AI 声音 轨道上,没有空位时放在新轨道上。符号会按字幕的语言读成文字,例如 33° 读作 33度,50% 读作百分之50。
参考一章列出所有文字样式、字幕样式和动画。